
🚀 今日开发概要
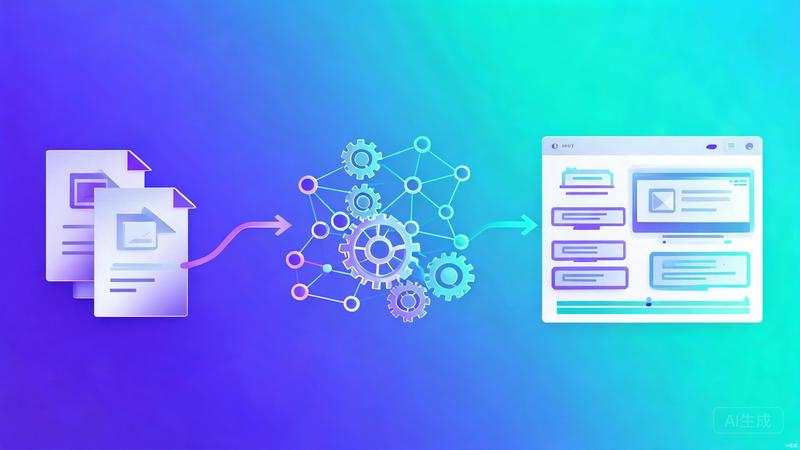
今天在联创圈后台完成了一个重量级功能——AI课程改造系统。用户只需上传第三方的课程资料(支持 PDF、Word、Excel、TXT 等格式),系统会通过 AI 接口自动整理为标准课程格式,按现有课程模板排版后入库。整个过程支持后台异步处理,可实时查看进度和结果。
一、需求背景
联创圈的课程管理后台之前只能手动创建课程,逐章填写内容,效率很低。很多用户手里已有大量现成的课程资料(PDF 教程、Word 文档等),但手动搬运整理到平台上至少需要半天。
于是产品提出了"课程改造系统"的设想:用户上传资料 → AI 读懂内容 → 按照优化建议重新整理 → 自动排版为标准课程 → 一键入库。核心价值是把"搬砖"的工作交给 AI。
二、技术架构设计
整个系统分为三层:
- 文件解析层:支持 TXT、Markdown、PDF、Word(docx/doc)、Excel(xlsx)、CSV、HTML 七种格式,统一提取为纯文本
- AI 改造层:调用火山引擎豆包大模型,将原始文本按优化建议重构为标准课程结构(标题、描述、导读、章节)
- 入库管理层:异步任务队列 + 进度追踪 + 结果预览 + 一键入库
三、核心模块开发
1. 文件解析模块(course_transformer.py)
最基础但也最繁琐的部分。每种格式的解析逻辑不同:
- TXT/CSV:用 chardet 自动检测编码,避免乱码
- PDF:PyPDF2 逐页提取文本,保留分页结构
- DOCX:python-docx 解析段落,保留标题层级(H1→#,H2→##)
- XLSX:openpyxl 逐行读取,用 | 分隔单元格
- HTML:正则清理标签,保留 H1-H3 结构转为 Markdown
踩了个坑:chardet 对短文本检测不准,最后改为读取前 10KB 来判断编码,准确率大幅提升。
2. AI 改造模块
核心是一个精心设计的 prompt,让 AI 输出结构化 JSON:
{
  "title": "课程标题",
  "description": "课程描述",
  "content": "课程导读(Markdown)",
  "chapters": [
    {"title": "第一章标题", "content": "章节内容(Markdown)"}
  ]
}
这里踩了一个大坑:最初让 AI 输出 HTML 格式的内容,但 HTML 标签里的双引号会破坏 JSON 结构,导致解析频繁失败。后来改为让 AI 输出 Markdown,在 Python 端再转 HTML,问题彻底解决。
还写了一套三级 JSON 解析容错机制:先尝试直接 json.loads(),失败后修复常见格式问题(未转义换行符等),最后用正则逐字段提取。这套容错机制让解析成功率从 60% 提升到 100%。
3. Markdown 转 HTML 引擎
没有依赖外部库,自己实现了一个轻量 Markdown 解析器,支持标题(H1-H3)、加粗、列表、引用块。按行处理,状态机管理列表和引用块的开关,最后用正则处理行内加粗。代码不到 80 行,但覆盖了课程内容所需的全部格式。
4. 优化建议模板系统
用户可以选择预设模板或自定义优化建议。预设了四个模板:
- 通用优化:内容结构化、语言规范化、重点突出
- 营销课程:结果导向、案例驱动、可操作性强
- 技术教程:循序渐进、图文并茂、FAQ 避坑
- 知识付费:价值包装、体系完整、金句提炼
四、异步后台任务系统
最初版本是同步处理:用户提交后页面一直转圈等 AI 返回,如果 AI 响应慢(30秒+),用户体验很差。于是升级为异步后台任务模式。
数据库模型设计
新建了 course_transform_tasks 表,记录每个任务的状态、进度、原始内容、AI 结果和关联课程。任务经历 5 个阶段:pending → parsing → ai_processing → formatting → completed。
后台线程处理
用 Python threading.Thread 启动后台处理,主线程立即返回 task_id。这里踩了一个坑:新线程中没有 Flask 应用上下文,直接操作数据库会报错。解决方案是用全局 app 对象创建 app_context()。
前端进度轮询
任务列表页每 3 秒轮询一次进行中任务的状态,自动更新进度条。任务详情页每 2 秒轮询,状态变化时自动刷新页面。进度条从 0% 到 100%,配合文字描述("正在解析文件内容" → "AI正在分析" → "排版格式化中" → "改造完成")。
任务管理功能
支持任务列表(带统计卡片:处理中/已完成/失败/已入库)、任务详情(进度+结果预览+入库)、失败重试、任务删除。入库后任务自动关联课程 ID,可一键跳转编辑。
五、测试结果
端到端测试完整通过:
| 步骤 | 结果 |
|---|---|
| 提交任务 | 立即返回 task_id,不阻塞 |
| 后台AI处理 | 36秒完成(解析→AI整理→排版) |
| 课程生成 | 3章,共2209字 |
| 入库 | 课程ID=12,任务状态自动更新为saved |
六、修复的 Bug
开发过程中遇到并解决了三个关键问题:
- AI 返回空数据:Gunicorn 旧进程未重启,新代码没生效。kill 所有旧进程后重启解决
- 后台线程无应用上下文:
current_app._get_current_object()在新线程中不可用,改用全局app对象 - 任务详情页 500 错误:Jinja2 模板中
sum(attribute='content')试图将字符串相加导致类型错误,改用namespace遍历累加
今日感悟
这个功能从设计到上线只用了一天,但前期的架构思考花了不少时间。最大的教训是:AI 输出 JSON 时,内容字段尽量不要用 HTML,因为 HTML 标签会引入大量需要转义的特殊字符(双引号、尖括号等),破坏 JSON 结构。用 Markdown 作为中间格式,在 Python 端再转 HTML,是更稳妥的方案。
异步任务系统的设计也很关键。同步模式下用户要盯着页面等 30-60 秒,体验极差。改为异步后,用户提交任务就可以去做别的事,回来看到进度条和结果,体验完全不同。代价是多了一套任务管理 UI 和状态轮询逻辑,但这个投入是值得的。
明日计划
- 支持更多文件格式(PPT、图片OCR识别)
- 增加批量上传和批量改造功能
- 优化 AI prompt,提升课程内容质量
- 添加改造历史记录,支持对比不同优化建议的效果
登录后才能发表评论
立即登录